Outil d'indexation Google : savoir quelles pages Google a retenues
Google fournit lui-même un outil d'indexation gratuit : la Search Console, avec son inspection d'URL et son rapport sur l'indexation des pages. Il te dit quelles pages Google a gardées, et pourquoi les autres non. SemChat sait lire ces données à ta place : je l'ai testé sur un vrai site, il trie bien, mais chacune de ses actions demande une vérification.
 Par Jérémy Santos Mis à jour le 30 octobre 2026 Testé sur son propre compte SemChat : premier audit le 29 octobre 2026.
Cette page fait partie du guide : référencement automatique
Savoir quelles pages Google a retenues, et pourquoi les autres non. Illustration Zéro Corvée.
Tu as publié une page, et personne ne la trouve sur Google. Avant tout, une question : Google l’a-t-il seulement gardée dans son index ? Un outil d’indexation Google sert à ça. Il te dit quelles pages sont dans l’index, lesquelles n’y sont pas, et pourquoi.
Cette page fait partie de notre dossier sur le référencement automatique : ce qu’un assistant comme SemChat fait à ta place, et ce que tu dois vérifier toi-même. Les citations de Google viennent de ses pages officielles, lues le 30/10/2026. Les boutons SemChat de cette page sont des liens affiliés.
Indexation de page Google : ce qu’un outil vérifie
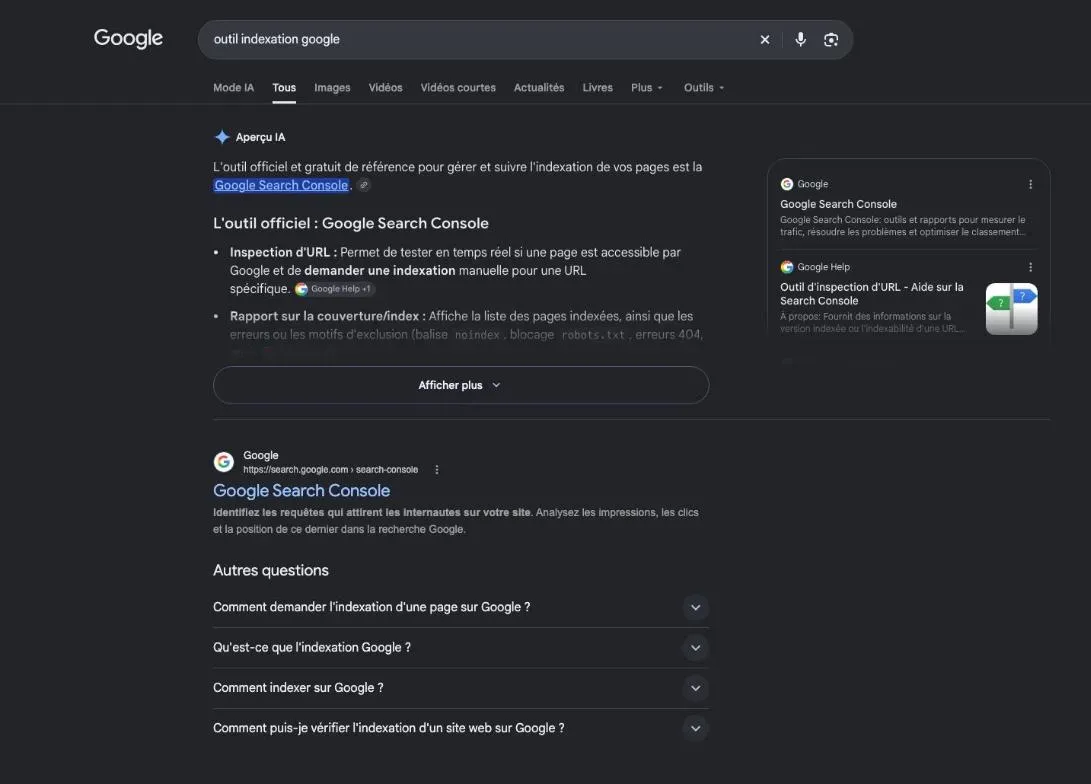
Tape « outil indexation google ». Le 29/10/2026, les trois premiers résultats venaient de Google lui-même (relevé DataForSEO, France) : la Search Console, l’aide de son outil d’inspection d’URL et sa page « Demander à Google d’explorer de nouveau vos URL ». L’outil existe donc déjà, et il ne coûte rien : Google présente la Search Console comme « un service gratuit ».
Son outil d’inspection d’URL « fournit des informations sur la version indexée par Google d’une page spécifique ». Pour une adresse de ton site, il répond à trois questions :
- Google la connaît-il, et comment l’a-t-il découverte ?
- A-t-il pu l’explorer, et quand ?
- L’a-t-il indexée, et sous quelle adresse ?
Une limite, écrite par Google : la mention « Cette URL est sur Google » ne garantit pas que ta page apparaîtra dans les résultats. Indexée ne veut pas dire bien placée.
L’indexation Google expliquée simplement
Google travaille en trois étapes, d’après sa page sur le fonctionnement de la recherche :
- l’exploration : ses robots téléchargent les pages qu’ils trouvent ;
- l’indexation : Google analyse le texte, les images et les vidéos, puis range le tout dans l’index, « une grande base de données » ;
- la diffusion : il montre les pages de l’index qui répondent à une recherche.
Une page hors de l’index ne peut pas sortir dans les résultats. Et Google prévient : « L’indexation n’est pas garantie. Toutes les pages que Google traite ne sont pas indexées. »
Ce que veut dire « indexé », et comment le vérifier pour une page ou tout un site, est détaillé sur notre page indexation Google.
Indexation Google Search Console : les statuts à lire
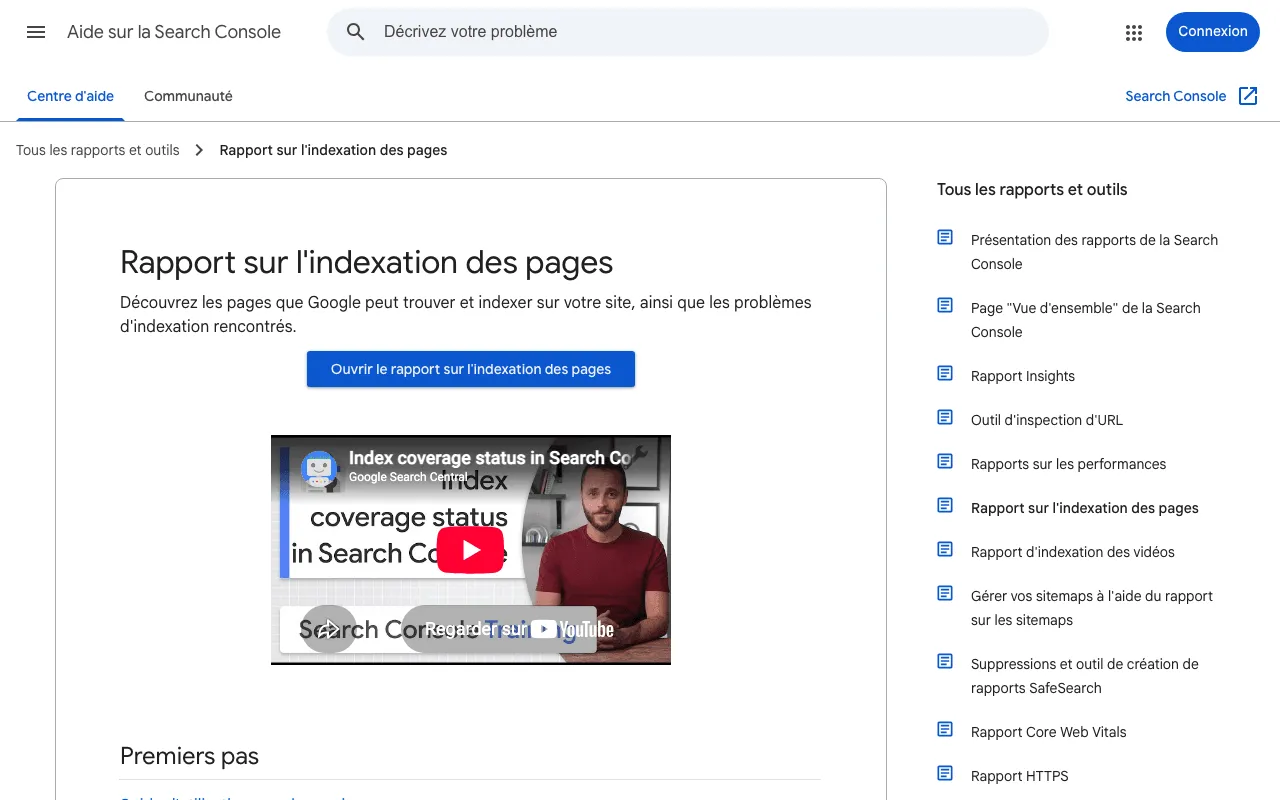
Pour tout ton site d’un coup, ouvre le rapport sur l’indexation des pages. Il range tes adresses en deux groupes : indexées, et non indexées avec leur raison. Pour une page précise, Google renvoie à l’outil d’inspection d’URL.
Trois statuts reviennent souvent. Voici leur définition par Google :
- « Explorée, actuellement non indexée » : « La page a été explorée par Google, mais pas indexée. Elle sera peut-être indexée à l’avenir ; il n’est pas nécessaire de renvoyer cette URL pour l’exploration. »
- « Détectée, actuellement non indexée » : « La page a été détectée par Google, mais n’a pas encore été explorée. »
- « Google ne reconnaît pas cette URL », dans l’inspection d’URL : Google « n’a jamais détecté cette URL ». Il conseille alors de demander l’indexation de la page.
Pourquoi certaines pages ne sont pas indexées
Une page absente de l’index n’est pas forcément un problème. Google l’écrit : « Le fait qu’une URL ne soit pas indexée ne pose aucun problème si les raisons en sont légitimes. » Ses exemples : une règle robots.txt voulue, une balise noindex, une adresse en double, une page supprimée qui répond en 404.
Pour un site neuf, il faut aussi de la patience : « Il faut jusqu’à une semaine pour que Google commence à explorer et à indexer une nouvelle page ou un nouveau site. » Ta vraie question est donc simple : mes pages importantes sont-elles indexées ?
Bloquée par toi, vue mais pas retenue, trop récente : les trois cas
| Bloquée par toi | Vue, pas retenue | Trop récente | |
|---|---|---|---|
| Ce qui se passe | noindex, robots.txt, redirection ou erreur | Google l'a vue sans la garder | Google ne l'a pas encore traitée |
| Ce que tu fais | vérifier que c'est voulu | améliorer la page et la relier | attendre, puis l'inspecter |
Ces trois cas sont ceux que j’ai demandés à SemChat dans mon test. Ils t’évitent de « corriger » une page qui n’a aucun problème, et de laisser filer une page bloquée par erreur.
La demande à taper dans SemChat, et ce qu’il a trouvé sur un vrai site
Le 29/10/2026, j’ai testé la compétence sur plugkit-avis.com, mon site, avec le plan Starter. Le site était neuf : la Search Console n’avait des données que depuis le 24/10/2026. C’est le test de la leçon L06 de la formation gratuite SemChat.
Le parcours : Nouveau chat, le bouton « + », Compétences, Audit Technique. Voici la phrase tapée, mot pour mot :
« Fais un audit technique SEO de plugkit-avis.com, centré sur l’indexation. Liste les pages que Google n’a pas indexées, en t’appuyant sur ma Search Console. Pour chacune, dis si elle est bloquée (noindex, robots.txt, erreur, redirection, canonique) ou si Google l’a vue sans la retenir. Range-les par cause, de celle qui touche le plus de pages à la moins fréquente, et dis-moi par quoi commencer. »
SemChat a proposé de lier la conversation au site. J’ai choisi « Non, lancer indépendamment ». Dans un test précédent, une conversation liée au site ne voyait pas la Search Console ; lancée à part, elle l’a lue.
Lancée par l’audit technique SEO automatique, l’indexation prend le relais
Je l’avais lancée comme un audit technique. Dès sa première réponse, SemChat a affiché le badge de la compétence Indexation : il est passé seul sur la compétence voisine.
Ses outils s’affichent dans la conversation : lecture des propriétés de la Search Console, exploration du site complet, puis inspections d’URL. Tu vois ce qu’il lit, et d’où viennent ses chiffres.
-10 % à vie sur ton abonnement avec mon lien, si tu t'abonnes dans les 2 semaines après ton inscription. Sans code. Tout sur le code promo SemChat
Essayer SemChat gratuitement Plan Free, sans carte bancaire. Lien affilié : ça ne te coûte rien de plus.
Les pages inspectées, cohérentes avec la Search Console
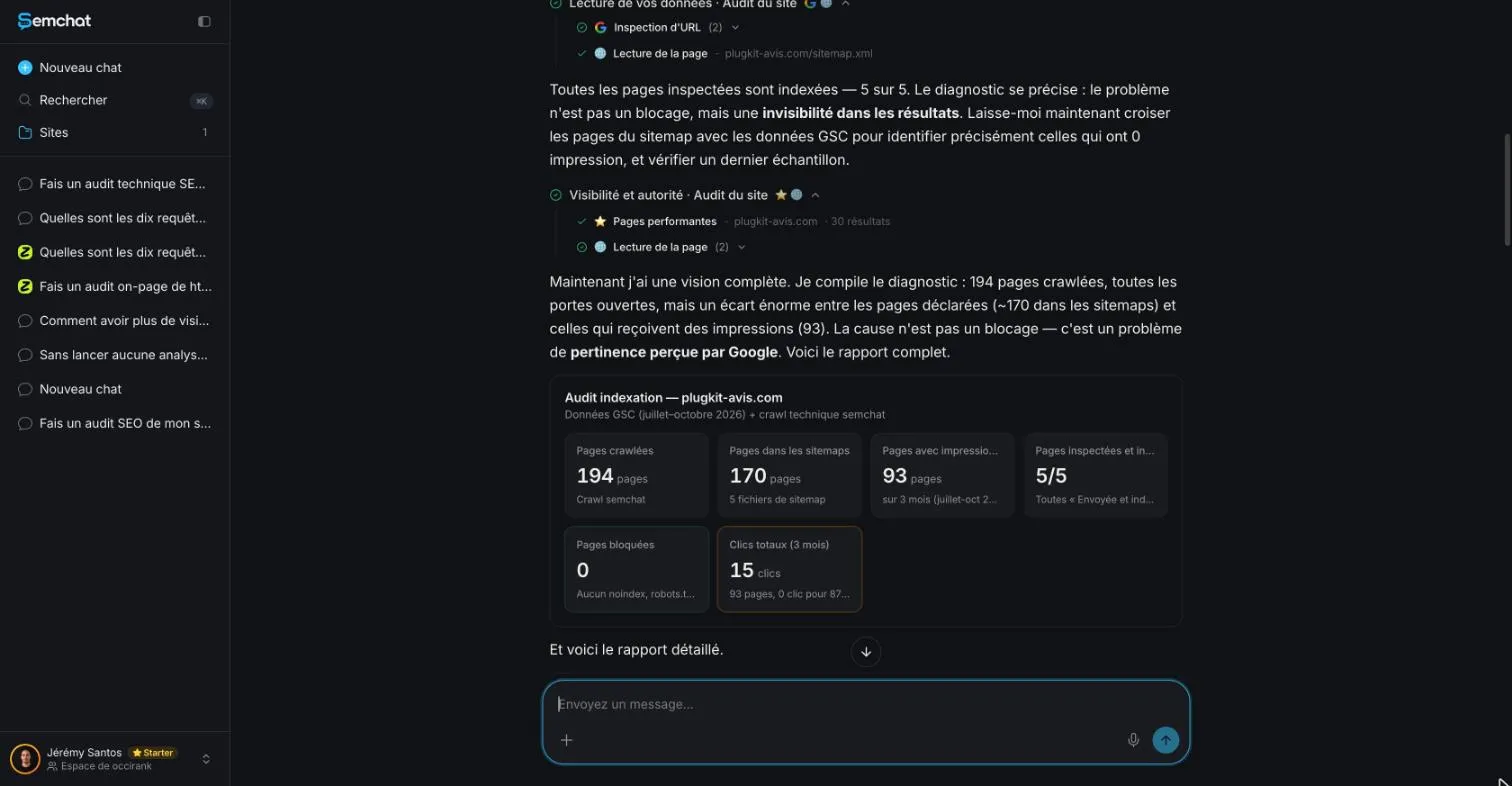
Il a inspecté 5 pages : 5 indexées. C’est juste. Mes propres inspections du même jour donnaient 10 pages « Submitted and indexed » (envoyées et indexées). Aucune page bloquée par erreur : juste aussi.
Deux mentions de sa carte méritent un œil, pourtant. Elle annonce 170 pages dans les sitemaps ; l’index de mes sitemaps en comptait 194 ce jour-là. Et elle date ses données de « juillet-octobre 2026 », pour un site suivi depuis le 24 octobre.
« J’avais tort sur trois points » : la relance qui corrige
Son premier diagnostic était faux sur trois points :
- il voyait environ 70 pages anglaises à zéro impression, et envisageait de les passer en noindex ; or la page manychat-pricing avait environ 27 à 30 impressions dans ma Search Console ;
- il ignorait que le site était neuf, avec des données depuis le 24/10/2026 ;
- il présentait 104 titres principaux (H1) en double comme du contenu générique ; ce sont 52 paires de pages en anglais américain et britannique.
Je l’ai relancé avec ces trois faits et une consigne : « Reprends le diagnostic en séparant trois cas : page bloquée par moi, page connue mais pas retenue par Google, page trop récente pour juger. Inspecte aussi les pages de contact. »
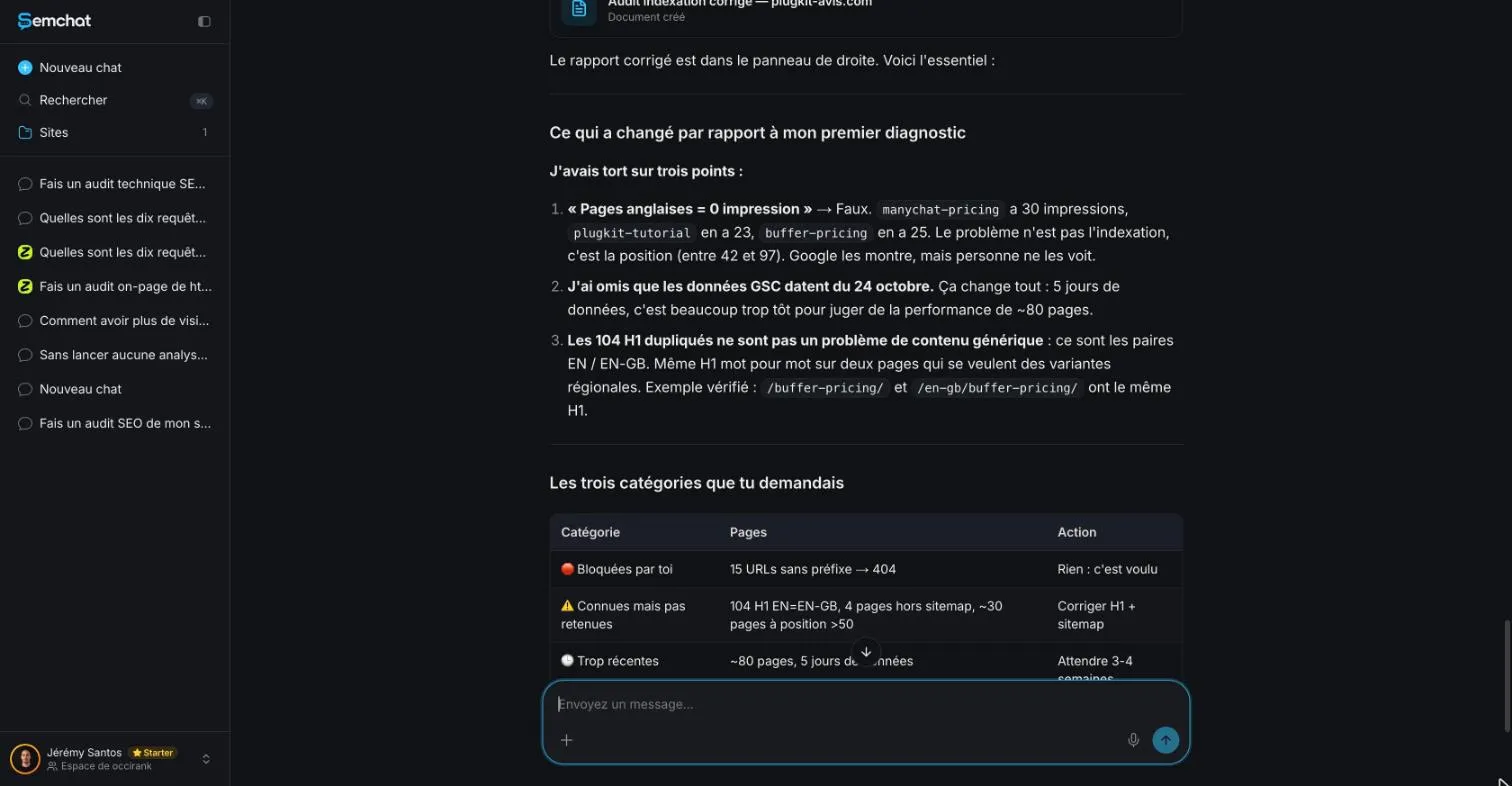
Sa réponse commence par « J’avais tort sur trois points ». Il range ensuite les pages en trois cas : « Bloquées par toi » (des adresses sans préfixe de langue, en 404, pour lesquelles il écrit « Rien : c’est voulu »), « Connues mais pas retenues » et « Trop récentes ».
Il compte aussi 4 pages que Google ne connaît pas. Mes inspections en confirment deux : /fr/contact/ et /pt-br/contato/ portaient le statut « URL is unknown to Google » (Google ne reconnaît pas cette URL), alors qu’elles figuraient dans mes sitemaps. Bien vu.
Les actions à ne pas suivre sans vérifier
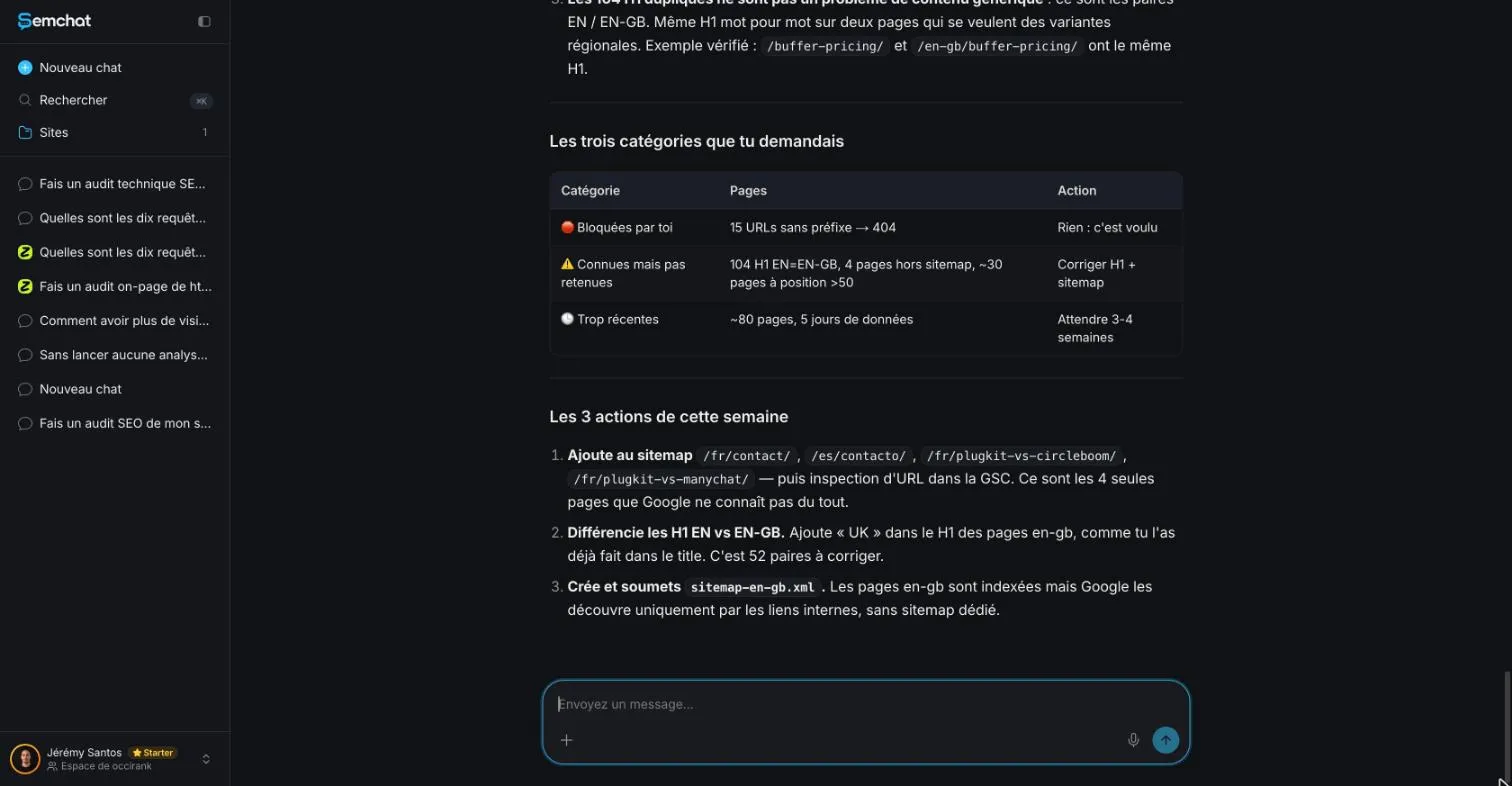
La réponse corrigée se termine par « Les 3 actions de cette semaine ». Je les ai vérifiées le jour même, sur les sitemaps et par des requêtes HTTP. Trois affirmations sont fausses.
Une page à ajouter au sitemap, qui y est déjà
Première action : ajouter /fr/contact/ au sitemap. Faux : elle était déjà dans le sitemap français. Le vrai sujet est ailleurs : Google ne la connaissait pas, alors qu’elle est liée dans le pied de page. Pour une page dans ce cas, Google donne la marche à suivre : l’inspecter, puis demander son indexation.
Des adresses mortes à ajouter, un sitemap à créer qui existe déjà
La même action ajoutait /fr/plugkit-vs-circleboom/ et /fr/plugkit-vs-manychat/. Faux encore : ces deux adresses répondaient en 404, avec une balise noindex. Les mettre au sitemap aurait envoyé Google vers des pages mortes. Elle citait aussi /es/contacto/ : donnée manquante, je ne l’ai pas vérifiée.
Troisième action : « Crée et soumets sitemap-en-gb.xml ». Ce fichier existait déjà : il répondait en 200, avec 51 adresses. La deuxième action, distinguer les H1 des pages américaines et britanniques, ne touche pas à l’indexation : je ne la juge pas ici.
Coût : donnée manquante pour ce test seul. Le quota du plan Starter a bougé de 22,4 points pour ce test et le suivant (un clustering de mots-clés), sans relevé entre les deux.
Mon bilan : un bon trieur de pistes, qui lit la Search Console et accepte d’être corrigé. Un mauvais exécutant : même corrigée, sa liste d’actions restait fausse. Demande-lui où regarder ; vérifie avant d’agir. Le test complet de l’outil est dans notre avis SemChat, et ses formules sur notre page prix SemChat.
Corriger une erreur d’indexation : robots.txt et noindex
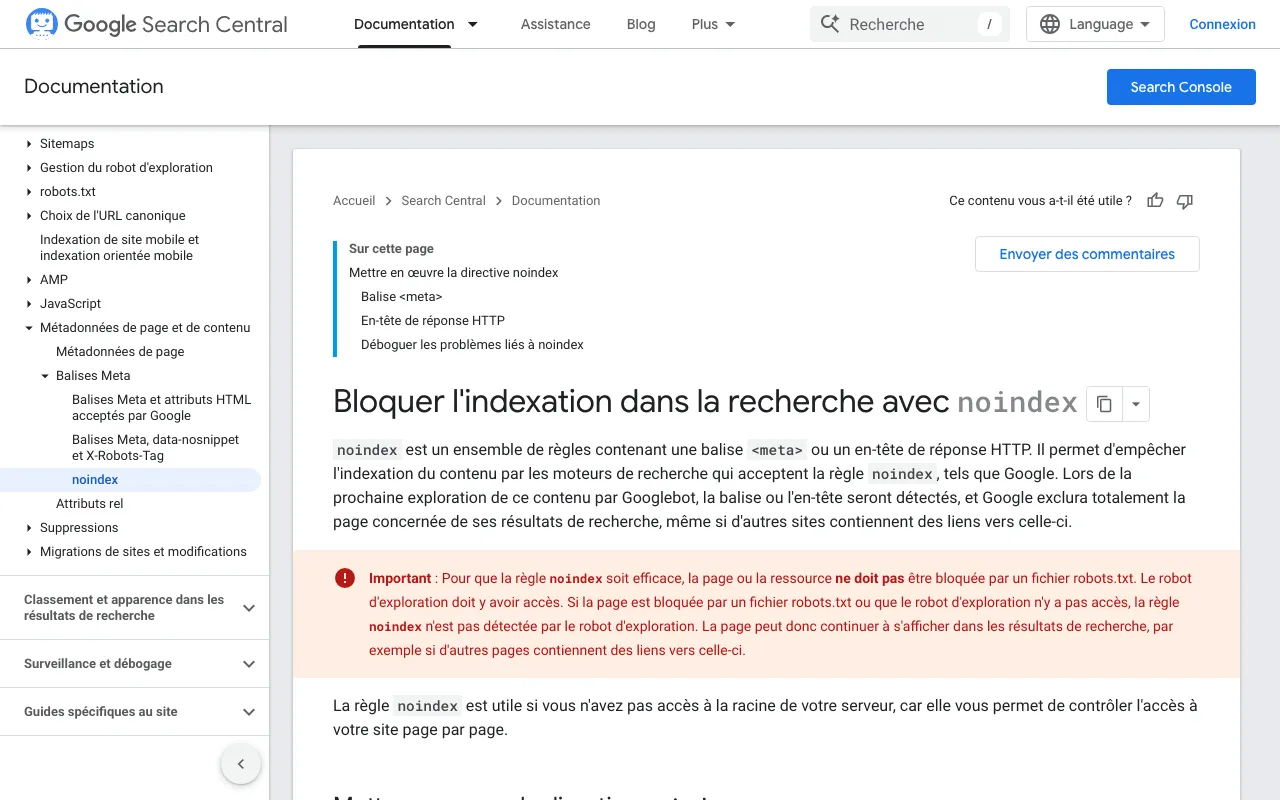
Deux réglages bloquent Google, et on les confond facilement :
- le fichier robots.txt « sert principalement à gérer le trafic des robots d’exploration sur votre site » : il dit à Google où il peut aller ;
- la règle noindex « permet d’empêcher l’indexation du contenu par les moteurs de recherche qui acceptent la règle noindex, tels que Google ».
Le piège : une page bloquée par robots.txt ne montre jamais sa balise noindex à Google. Google l’écrit en encadré : « Pour que la règle noindex soit efficace, la page ou la ressource ne doit pas être bloquée par un fichier robots.txt. »
Une page importante tombe dans le cas « bloquée par toi » ? Cherche une balise noindex oubliée, une ligne du robots.txt, puis une redirection.
Demander à Google d’explorer tes pages : ce qu’il conseille
La méthode complète, étape par étape, est sur notre page indexer son site sur Google. L’essentiel, d’après Google :
- sous WordPress ou une autre plateforme hébergée, « dans la plupart des cas, la plate-forme envoie automatiquement votre nouveau contenu aux moteurs de recherche » ;
- pour quelques pages, le bouton « Demander une indexation » de l’inspection d’URL ; mais « un quota limite l’envoi d’URL individuelles » ;
- pour beaucoup de pages, un sitemap envoyé dans la Search Console, qui n’est « qu’une suggestion ».
Rien ne force Google : « Une demande d’exploration ne garantit pas que l’inclusion dans les résultats de recherche se produira instantanément. » Méfie-toi des promesses d’indexation express. Le 29/10/2026, un résultat de cette même recherche annonçait une indexation « en 24 heures ». Google, lui, écrit qu’il n’accepte « aucun paiement pour explorer un site plus fréquemment ».
Et une fois tes pages dans l’index ? Pour un site qui vient d’ouvrir, vois notre page sur le lancement de site automatique. Pour choisir les pages à écrire, notre guide comment faire une stratégie SEO. Pour voir où tes concurrents passent devant toi, l’analyse concurrentielle SEO automatique. Pour un commerce de quartier, comment faire du SEO local.
Retiens ceci : ton premier outil d’indexation Google, c’est la Search Console. SemChat peut la lire pour toi et trier tes pages en trois cas, à condition de le relancer quand il se trompe et de vérifier chaque action avant de la suivre.
Questions fréquentes
À quoi sert la Search Console de Google ?
C'est l'outil de Google pour suivre ton site. Google la présente comme « un service gratuit » qui aide à « contrôler et maintenir la présence de votre site dans les résultats de recherche Google » (aide Search Console, lue le 30/10/2026). Tu y vois quelles pages sont indexées et sur quelles recherches tu apparais ; tu peux y inspecter une adresse ou envoyer un sitemap. Pas besoin de t'y inscrire pour apparaître dans Google, mais sans elle, tu ne vois rien de tout ça.
Comment fonctionne le robot d'indexation de Google ?
Le robot s'appelle Googlebot. Il découvre des pages par les liens et par les sitemaps, puis les télécharge : c'est l'exploration. Google analyse ensuite la page et peut la ranger dans son index. Google précise que Googlebot « n'explore pas toutes les pages » et que l'indexation « n'est pas garantie » (fonctionnement de la recherche Google, lu le 30/10/2026).
Peut-on forcer l'indexation d'une page par Google ?
Non. Tu peux la demander dans l'outil d'inspection d'URL de la Search Console, mais Google écrit : « Une demande d'exploration ne garantit pas que l'inclusion dans les résultats de recherche se produira instantanément. Il est même possible qu'elle n'ait pas lieu du tout. » Un quota limite ces demandes, et les répéter pour la même adresse n'accélère rien (page lue le 30/10/2026).
Combien de temps faut-il pour qu'une page soit indexée ?
Pour un site ou une page neuve, Google écrit qu'il faut « jusqu'à une semaine » pour qu'il commence à explorer et à indexer. Après une demande d'indexation : « L'indexation ne prend généralement qu'un jour ou deux, mais peut être beaucoup plus longue. » Et l'exploration elle-même « peut prendre plusieurs jours, voire plusieurs semaines » (pages d'aide de Google, lues le 30/10/2026).
SemChat peut-il demander l'indexation de mes pages ?
Pas dans notre test du 29/10/2026 : ses outils ont lu la Search Console (propriétés, inspections d'URL) et exploré le site, sans rien envoyer à Google. Il t'aide à savoir quelles pages manquent et pourquoi. La demande d'indexation, tu la fais toi-même, dans l'inspection d'URL de la Search Console.
Laisse ton IA faire les corvées de ta visibilité en ligne.
-10 % à vie sur ton abonnement avec mon lien, si tu t'abonnes dans les 2 semaines après ton inscription. Sans code. Tout sur le code promo SemChat
Lien affilié : ça ne te coûte rien de plus.
Sources vérifiées
- Aide Search Console : rapport sur l'indexation des pages (30/10/2026)
- Aide Search Console : outil d'inspection d'URL (30/10/2026)
- Aide Search Console : à propos de la Search Console (30/10/2026)
- Google Search Central : fonctionnement de la recherche Google (30/10/2026)
- Google Search Central : bloquer l'indexation dans la recherche avec noindex (30/10/2026)
- Google Search Central : introduction au fichier robots.txt (30/10/2026)
- Google Search Central : demander à Google d'explorer de nouveau vos URL (30/10/2026)
- Google Search Central : créer et envoyer un sitemap (30/10/2026)
- Tarifs de SemChat (plan Free, toutes les fonctionnalités dans chaque plan) (29/10/2026)