Indexation Google : ce que veut dire « indexé », comment le vérifier
L'indexation Google, c'est le moment où Google analyse ta page et la range dans son index, une grande base de données. Une page qui n'y est pas ne peut pas apparaître dans les résultats. Pour savoir si la tienne y est, la référence gratuite est l'outil d'inspection d'URL de la Search Console. Et une page indexée n'est pas forcément bien placée : ce sont deux étapes différentes.
 Par Jérémy Santos Mis à jour le 30 octobre 2026 Testé sur son propre compte SemChat : premier audit le 29 octobre 2026.
Cette page fait partie du guide : Search Console, c'est quoi
L’index de Google, une immense bibliothèque où ton site doit trouver sa place. Illustration Zéro Corvée.
Tu as publié une page, et Google ne la montre pas. Avant de parler de position, une question passe en premier : ta page est-elle dans l’index ? C’est tout le sujet de l’indexation Google. Ce guide explique ce que veut dire « indexé », comment le vérifier et ce que disent les statuts de la Search Console, d’après les aides officielles de Google lues le 30/10/2026. Si tu découvres l’outil, commence par la page Search Console, c’est quoi. Les boutons SemChat de cette page sont des liens affiliés.
L’indexation Google, définition simple
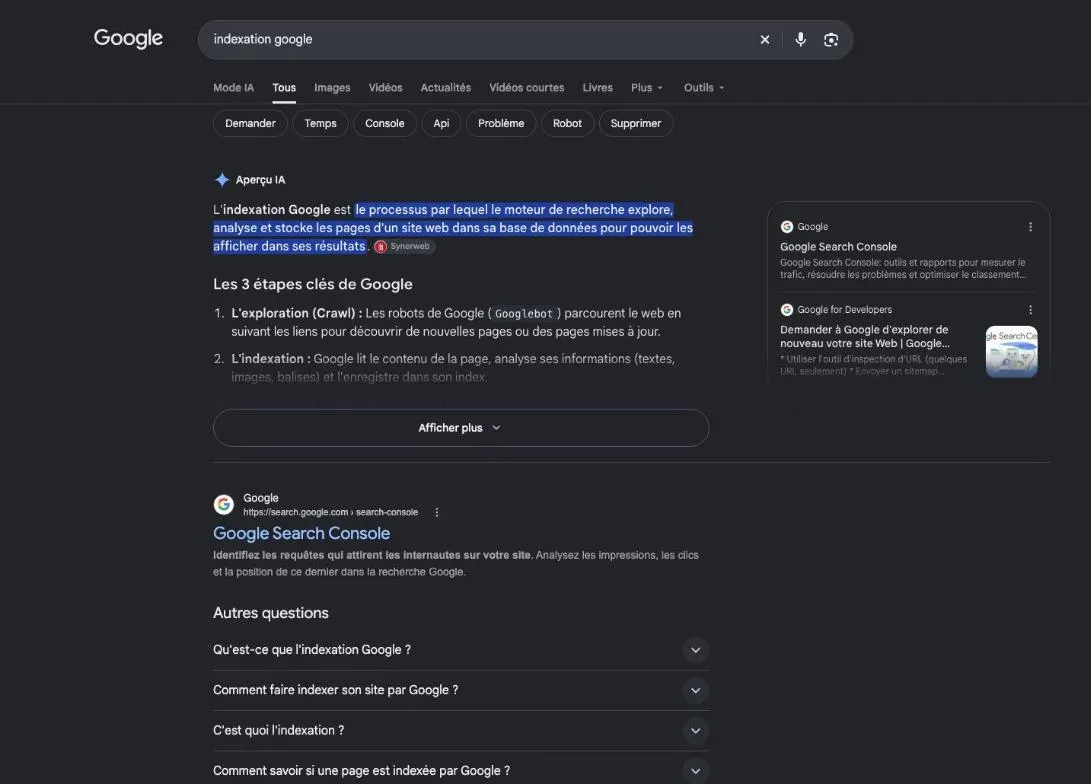
Google résume son fonctionnement en une phrase : la recherche Google « fonctionne en trois étapes : toutes les pages ne les réussissent pas ». L’indexation est la deuxième. Google y « analyse le texte, les images et les fichiers vidéo présents sur la page, puis stocke les informations dans l’index Google, qui est une grande base de données » (guide détaillé de la recherche Google, developers.google.com, lu le 30/10/2026).
Pense au catalogue d’une bibliothèque. Une page indexée a sa fiche : Google sait ce qu’elle contient et peut la proposer quand quelqu’un cherche. Une page absente du catalogue n’existe pas pour les résultats, même si elle est en ligne.
Rien n’est automatique pour autant. Google l’écrit : il « ne garantit pas que votre page sera explorée, indexée ou diffusée, même si elle respecte les Essentiels de la recherche Google ».
Explorer, indexer, classer : trois étapes différentes
On mélange souvent les trois mots. Google, lui, les sépare :
- Explorer : Googlebot, le robot de Google, télécharge le texte, les images et les vidéos d’une page qu’il a trouvée.
- Indexer : Google analyse la page et range ce qu’il en a compris dans son index.
- Classer et diffuser : à chaque recherche, Google cherche les pages correspondantes dans son index et affiche celles qu’il juge les plus pertinentes.
- 1 Explorer Googlebot visite la page et télécharge son contenu.
- 2 Indexer Google analyse la page et la range dans son index.
- 3 Classer et diffuser À chaque recherche, Google choisit les pages à montrer.
Tout le vocabulaire de la Search Console suit cet ordre. « Détectée » : Google connaît l’adresse. « Explorée » : il a visité la page. « Indexée » : il l’a gardée. Une page peut s’arrêter à chaque marche.
Comment Google indexe un site : ce qui décide
Pour l’indexation d’un site, Google n’attend pas qu’on l’inscrive. Il le dit : « La plupart des sites qui figurent dans nos résultats n’ont pas été envoyés manuellement », ses robots les trouvent en explorant le Web. Une page nouvelle se découvre de deux façons : par un lien depuis une page que Google connaît déjà, ou par un sitemap, la liste de pages que tu lui envoies. Le fichier est expliqué sur la page sitemap, c’est quoi.
Pendant l’indexation, Google regroupe aussi les pages au contenu très proche et en choisit une, la plus représentative : la page canonique, « la page qui peut s’afficher parmi les résultats de recherche ».
Google cite trois problèmes d’indexation courants :
- le contenu de la page est de faible qualité ;
- les règles meta robots interdisent l’indexation ;
- la conception du site rend l’indexation difficile.
Et il n’existe aucun raccourci payant : Google « n’accepte aucun paiement pour explorer un site plus fréquemment ou améliorer son classement ».
Googlebot, le robot d’indexation de Google
Googlebot est le programme qui visite les pages. Il en existe deux versions, une pour smartphone et une pour ordinateur, et Google précise : « Pour la plupart des sites, la recherche Google indexe principalement la version mobile du contenu » (page Googlebot, lue le 30/10/2026). Ce que ton site montre sur téléphone compte donc en premier.
Googlebot ne visite pas tout : certaines pages lui sont fermées par leur propriétaire, d’autres demandent une connexion.
Le rendu de la page, l’étape qu’on oublie
Pendant l’exploration, Google « affiche la page et exécute tout code JavaScript détecté à l’aide d’une version récente de Chrome ». C’est le rendu. Il compte, parce que beaucoup de sites affichent une partie de leur contenu par un script : sans le rendu, « il est possible que Google ne voie pas le contenu ».
Pour voir ta page comme Google la voit, l’outil d’inspection d’URL affiche une capture d’écran de la version rendue. Si un bloc important manque sur cette capture, c’est un signal à creuser.
Le rôle de l’indexation sur Google dans ton référencement
À quoi sert l’index de Google
L’index est le seul endroit où Google cherche. « Lorsqu’un internaute saisit une requête, nos ordinateurs recherchent les pages correspondantes dans l’index », écrit-il. Une page hors de l’index ne peut donc sortir sur aucune recherche.
C’est pourquoi l’indexation sur Google se vérifie avant tout le reste : mots-clés, titres et liens ne servent à rien pour une page que Google n’a pas gardée.
Indexée ne veut pas dire bien placée
Google le reconnaît : « Il est possible qu’une page soit indexée dans la Search Console, mais qu’elle ne s’affiche pas dans les résultats de recherche. » Les raisons qu’il donne : un contenu pas pertinent pour les recherches, un contenu de faible qualité, ou des règles meta robots qui empêchent la diffusion.
Et quand ta page s’affiche, sa place dépend de qui regarde. Ne mélange pas trois chiffres :
- Ta propre recherche : Google personnalise ses résultats selon l’historique, la zone géographique et d’autres variables. Ce que tu vois n’est pas ce que voient tes clients.
- La position moyenne de la Search Console : la moyenne de toutes les fois où ta page a été vue. Google cite lui-même le cas d’une page en position 5 dans le rapport, que son propriétaire trouve en 8e position en cherchant (aide lue le 30/10/2026).
- Le relevé d’un outil SEO : une mesure faite par un outil tiers, à une date et depuis un pays donnés.
Le classement est une autre histoire. Ici, on reste sur la marche d’avant : être dans l’index. Une fois tes pages indexées, le guide améliorer son référencement sur Google t’aide à trouver ce qui bloque et à corriger dans l’ordre.
Vérifier si une page est indexée par Google
L’inspection d’URL de la Search Console, la référence
C’est l’outil à utiliser pour une page précise. Google le présente ainsi : « L’outil d’inspection d’URL fournit des informations sur la version indexée par Google d’une page spécifique. » Tu colles l’adresse complète de ta page dans la barre en haut de la Search Console, et tu lis le verdict :
- « Cette URL est sur Google » : la page est indexée et peut figurer dans les résultats, sans garantie.
- « Cette URL n’a pas été indexée par Google » : la page ne peut pas apparaître dans les résultats ; la section « Indexation des pages » en donne la raison.
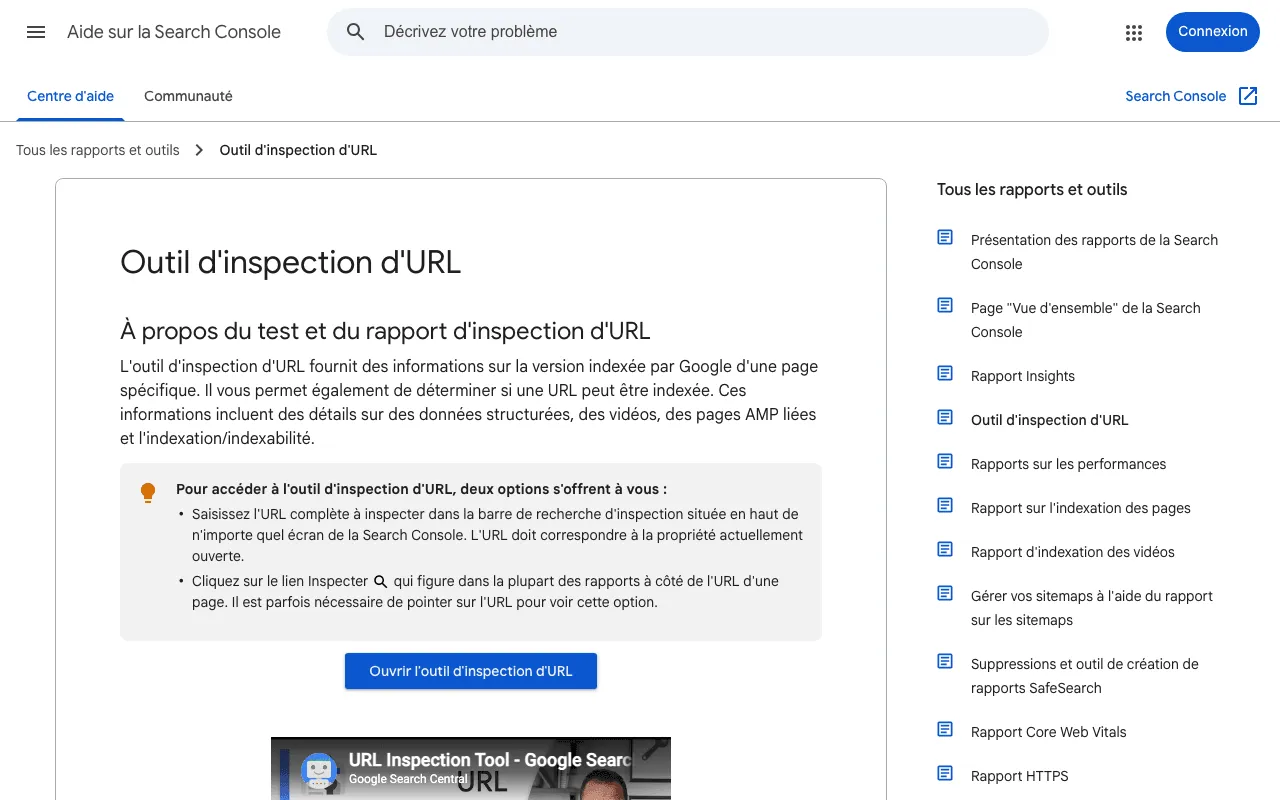
Trois précisions de l’aide. Le résultat vient de la dernière version indexée, pas de ta page en ligne : un bouton de test en ligne vérifie la version actuelle. L’outil indique aussi comment Google a trouvé l’adresse, quand il l’a explorée et quelle page canonique il a retenue. Enfin, le nombre d’inspections est limité chaque jour, et l’outil ne marche que sur un site que tu gères dans ta Search Console.
Le même outil sert à demander l’indexation. La marche à suivre, pas à pas, est sur la page indexer son site sur Google.
La commande site: dans Google, rapide mais approximative
Sans compte, tape dans Google site: suivi de ton domaine, par exemple site:example.com, ou l’adresse exacte d’une page. Tu vois des pages que Google connaît. C’est rapide, mais approximatif : Google écrit qu’une page indexée peut figurer dans ces résultats, « mais cela n’est pas garanti », et que la liste « n’est pas toujours exhaustive ». Si une page manque, Google conseille de passer par l’inspection d’URL, qui reste la référence.
Le rapport « Indexation des pages » pour tout ton site
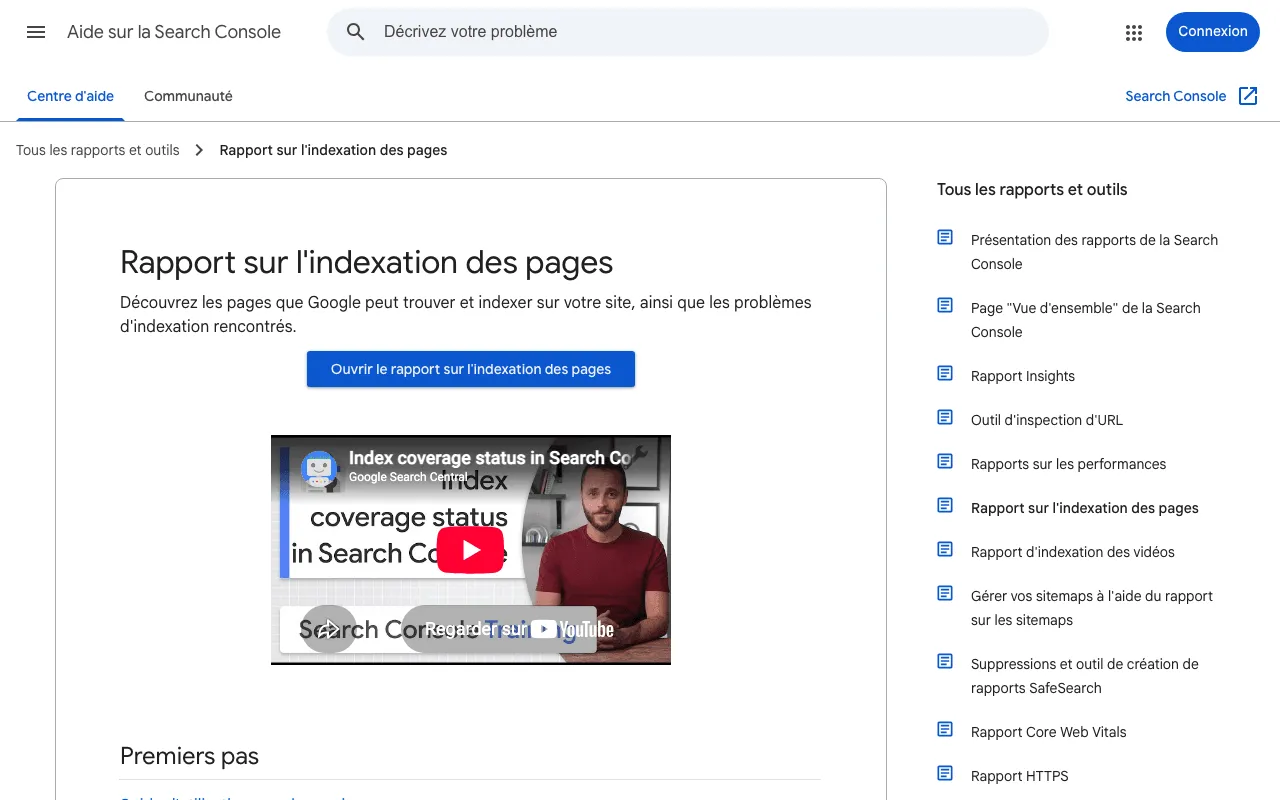
Pour une vue d’ensemble, la Search Console a un rapport qui « indique l’état d’indexation de toutes les URL dont Google a connaissance sur votre site ». Un graphique sépare les pages indexées et non indexées, et un tableau « Pourquoi des pages ne sont pas indexées » donne chaque motif. Sa colonne « Source » te dit qui peut corriger : en général, tu ne règles que les problèmes dont la source est « Site Web ».
Deux limites à connaître. Le rapport ne se filtre pas par adresse : pour une page précise, retourne à l’inspection d’URL. Et pour un petit site, Google est franc : « Si votre site comporte moins de 500 pages, ce rapport ne vous sera probablement d’aucune utilité. » Il conseille alors les recherches site: sur tes pages clés, dont la page d’accueil.
Les statuts d’indexation de la Search Console, traduits en clair
Premier réflexe : ne panique pas devant le gris. Google le dit, l’état « Non indexée » n’est pas un problème en soi. Ce qui compte, c’est le motif, et si cette page devait vraiment être indexée.
Détectée ou explorée, actuellement non indexée
Deux statuts voisins, deux situations différentes :
- Détectée, actuellement non indexée : « La page a été détectée par Google, mais n’a pas encore été explorée. » Google voulait l’explorer, mais a reporté pour ne pas surcharger ton site.
- Explorée, actuellement non indexée : « La page a été explorée par Google, mais pas indexée. Elle sera peut-être indexée à l’avenir ; il n’est pas nécessaire de renvoyer cette URL pour l’exploration. »
Les causes du second et ce que tu peux y faire sont détaillés sur la page explorée actuellement non indexée.
Page en double : quand Google retient une autre URL
Quand deux adresses montrent presque le même contenu, Google n’en garde qu’une. Le rapport l’indique de plusieurs façons :
- Autre page avec balise canonique correcte : la page renvoie bien vers sa version principale, qui est indexée. Rien à faire.
- Page en double sans URL canonique sélectionnée par l’utilisateur : Google a choisi l’autre page. « Il ne s’agit pas d’une erreur », précise l’aide.
- Page en double : Google a choisi une autre URL canonique que l’utilisateur : tu as désigné une page principale, Google en préfère une autre.
- Page avec redirection : l’adresse renvoie ailleurs. C’est la page d’arrivée qui peut être indexée.
Pour un doublon, l’inspection d’URL te montre la page canonique retenue par Google.
Exclue par la balise noindex ou bloquée par robots.txt
La balise noindex dit à Google de ne pas indexer une page. Si c’était voulu, l’aide te félicite presque : « Si vous ne voulez pas que la page soit indexée, vous avez procédé correctement. » Sinon, retire la balise.
Le fichier robots.txt, lui, interdit l’exploration, pas l’indexation. Google prévient qu’un blocage par robots.txt « ne garantit pas que la page ne sera pas indexée par d’autres moyens ». Pire : il empêche Google de lire une balise noindex posée sur la page. D’où sa consigne : « Pour empêcher Google d’indexer la page, supprimez le bloc robots.txt et utilisez une directive “noindex”. »
Page introuvable ou erreur du serveur
- Introuvable (404) : la page n’existe pas ou plus. « Les réponses 404 ne sont pas nécessairement un problème si la page a été supprimée sans avoir été remplacée », écrit Google. Une page déplacée mérite une redirection 301. Corrige d’abord les 404 que ton site lie ou que ton sitemap liste.
- Erreur serveur (5xx) : Googlebot n’a pas pu accéder à la page, ou ton serveur était trop lent. Ces erreurs peuvent être passagères ; si elles durent, parle à ton hébergeur.
Pourquoi une page n’est pas indexée
Une page trop récente ou mal reliée
Une page neuve demande du temps : « Il faut jusqu’à une semaine pour que Google commence à explorer et à indexer une nouvelle page ou un nouveau site », écrit l’aide. Et Google doit la trouver : la page doit être liée depuis une page qu’il connaît, ou figurer dans un sitemap.
Si ton site tourne sur WordPress, Google note que, dans la plupart des cas, une plate-forme hébergée de ce type envoie seule ton nouveau contenu aux moteurs (le réglage est détaillé dans le guide du sitemap xml wordpress). Le point de départ reste le même pour tous : vérifie que ta page d’accueil est indexée. Google le recommande « vivement » : avec une navigation bien pensée, il trouve tes autres pages à partir d’elle.
Un contenu trop faible ou trop proche d’une autre page
Google l’écrit sans détour : « Certaines URL ne sont pas indexées, car il s’agit de doublons ou parce qu’elles ne contiennent pas d’informations significatives. » Une page très courte, ou presque identique à une autre de ton site, a peu de chances d’être gardée. Même chose pour les variantes d’une boutique qui filtrent ou trient les mêmes produits (couleur, prix) : Google ne les indexe généralement pas.
Le remède n’est pas technique : donne à chaque page une raison d’exister, une réponse que les autres pages n’apportent pas.
Demander l’indexation et patienter : la marche à suivre
Une fois la cause réglée, tu peux demander l’indexation d’une page avec l’inspection d’URL. Trois règles de Google à garder en tête :
- il faut être « propriétaire ou un utilisateur avec accès complet » de la propriété Search Console ;
- « un quota limite l’envoi d’URL individuelles et […] les demandes répétées de réexploration pour une même URL n’accélèrent pas l’exploration » ;
- « L’exploration peut prendre plusieurs jours, voire plusieurs semaines. »
Pour beaucoup de pages à la fois, envoie plutôt un sitemap. Le détail de chaque geste est sur la page indexer son site sur Google.
Pages indexables ou pages indexées : la différence sur un audit réel
Deux mots se ressemblent, et les outils les mélangent. Une page indexable est une page que rien n’empêche d’indexer : elle répond correctement, sans noindex ni blocage. Une page indexée est une page que Google a vraiment gardée. Seule la Search Console peut te donner la seconde.
| Page indexable | Page indexée | |
|---|---|---|
| Qui le dit | un outil qui lit ta page | Google, dans la Search Console |
| Ce que ça veut dire | rien n'empêche Google de l'indexer | Google l'a rangée dans son index |
| Où le vérifier | un audit ou un robot d'exploration | l'inspection d'URL ou le rapport d'indexation |
Je l’ai vu sur un vrai site, le 29/10/2026 : plugkit-avis.com, mon site d’affiliation, si neuf que sa Search Console n’avait des données que depuis le 24/10/2026. Dans l’onglet « Visibilité des pages » de SemChat, le verdict était « Tout est bon » : « Nous avons vérifié 189 pages · 189 visibles dans les recherches · 0 cachées ». Visibles au sens de SemChat : aucune page cachée. Pas forcément indexées pour autant.
J’ai ensuite lancé la compétence Indexation de SemChat, branchée à ma Search Console, en lui demandant de lister les pages que Google n’avait pas indexées et de les ranger par cause. Il a inspecté 5 adresses : les 5 étaient indexées. Son premier diagnostic, lui, était faux. Il annonçait environ 70 pages anglaises à 0 impression et envisageait de les passer en noindex, alors que la page manychat-pricing avait déjà environ 27 à 30 impressions. Il présentait aussi 104 titres H1 en double comme du contenu générique : ce sont 52 paires de pages en anglais américain et britannique.
À la relance, il a admis : « J’avais tort sur trois points ». Sa carte corrigée comptait 93 pages avec au moins une impression et 4 pages inconnues de Google, sur 5 jours de données.
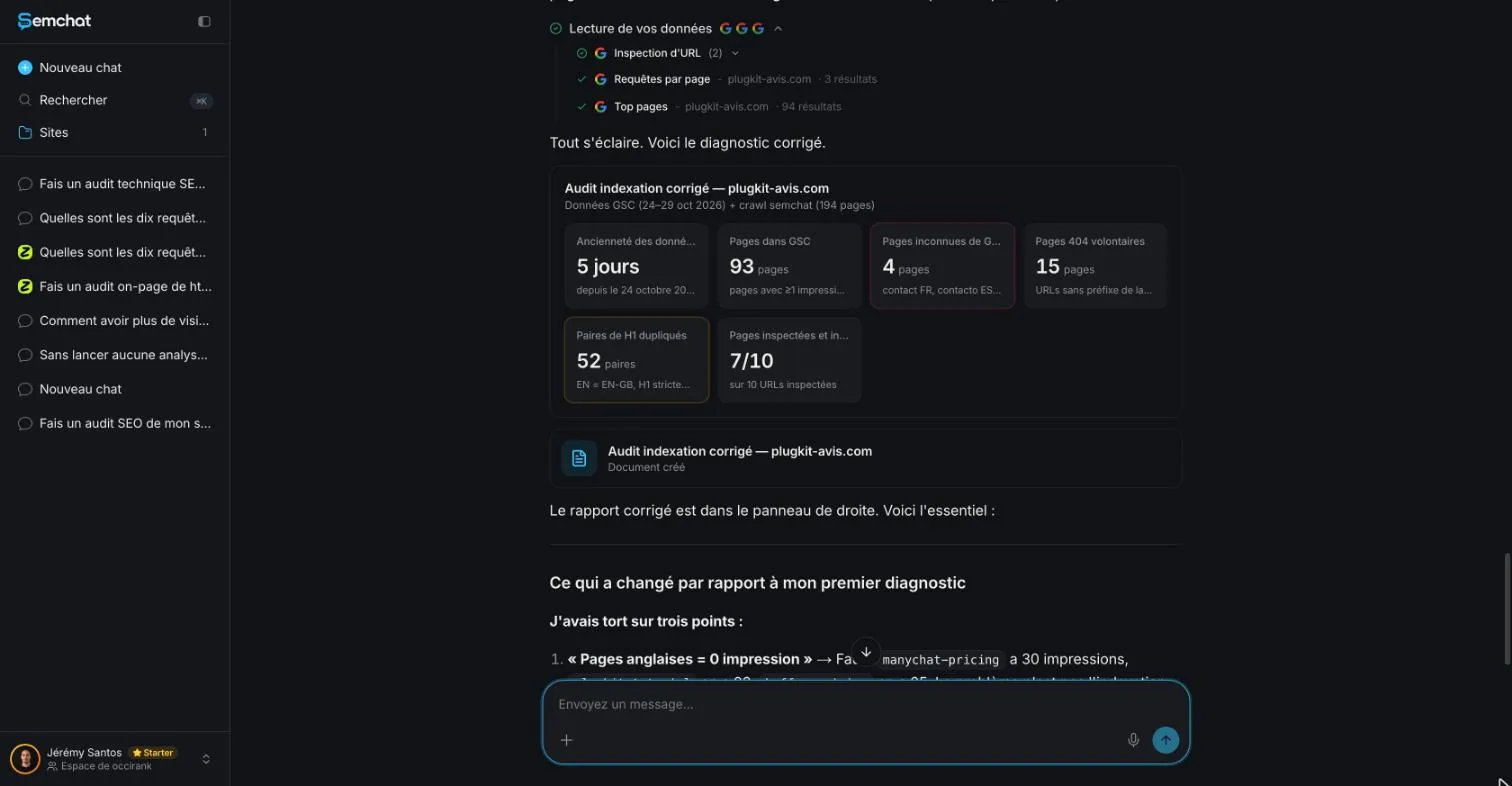
J’ai tout revérifié. L’inspection d’URL donnait bien /fr/contact/ et /pt-br/contato/ comme « URL is unknown to Google » (Google ne connaît pas cette URL), alors que les deux pages étaient dans les sitemaps. En revanche, deux autres de ses « pages inconnues » répondaient en 404 avec un noindex : elles ne devaient pas être indexées. SemChat comptait aussi environ 170 pages dans les sitemaps, quand l’index de sitemaps en listait 194.
Ses actions finales contenaient encore trois erreurs : ajouter /fr/contact/ au sitemap (elle y était déjà), ajouter ces deux pages en 404, et créer un sitemap pour l’anglais britannique (il existait, avec 51 adresses). La leçon : SemChat trie vite et sait se corriger, mais chaque action se vérifie dans la Search Console avant d’agir. Ce cas est repris dans la formation gratuite SemChat, avec la relance qui a fait corriger SemChat.
Ce que l’audit SemChat de plugkit-avis.com a compté
Le même jour, j’ai demandé un audit SEO complet du site, en une phrase. Parmi ses chiffres clés, une carte « Pages indexables : 189 pages, toutes en 200 ». Le code 200 veut dire que la page répond normalement. Ce chiffre dit donc que 189 pages sont prêtes à être indexées. Il ne dit pas combien Google en a gardé.
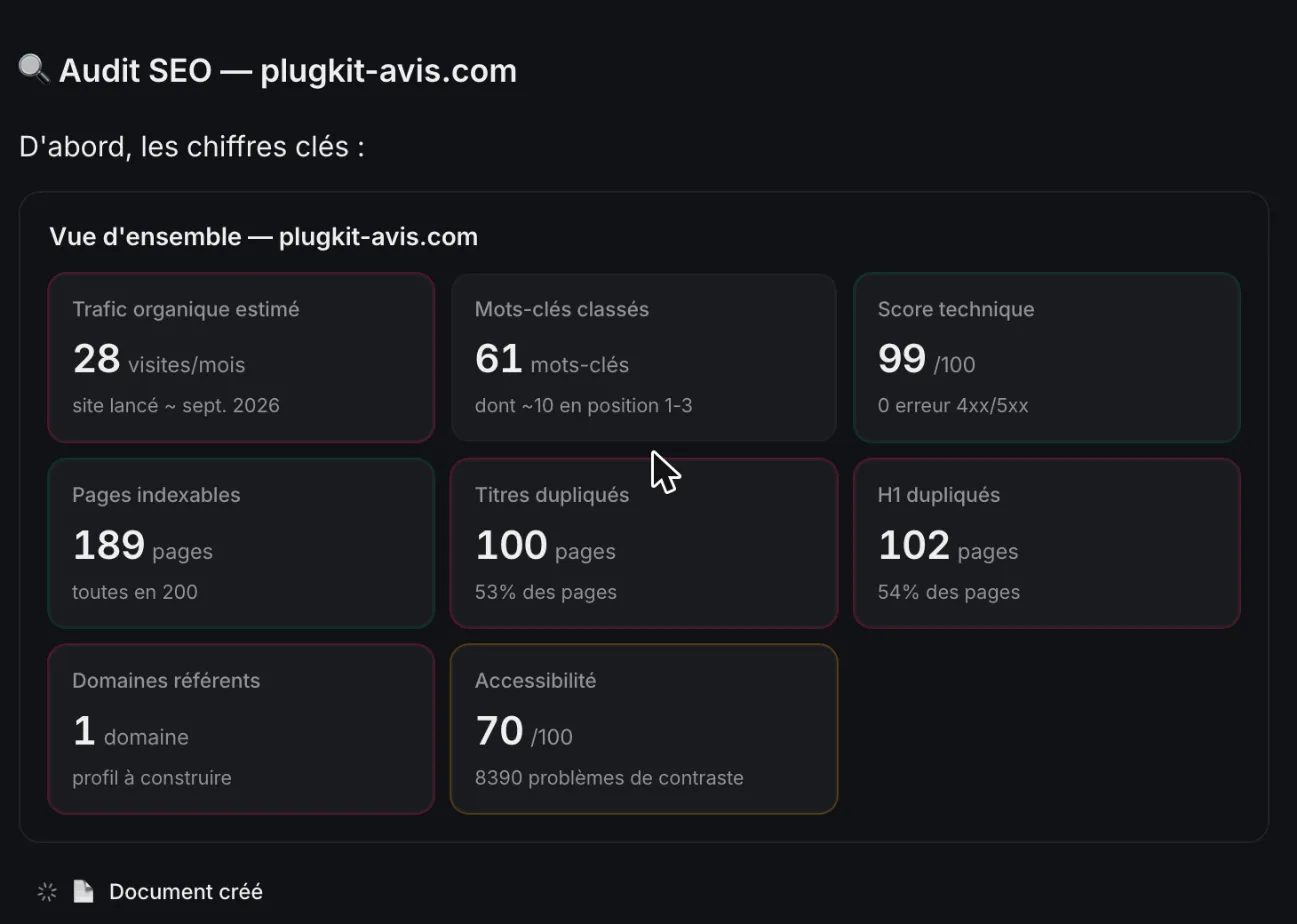
Un point de coût : cet audit complet a consommé 100 % du quota mensuel du plan Free. Mon test complet est dans mon avis SemChat, et les plans sur la page prix SemChat.
Faut-il indexer toutes les pages de ton site ?
Non. Google pose lui-même la question dans son aide : « Est-il possible qu’une page ne soit pas indexée ? » Sa réponse : « Absolument. » Les pages bloquées volontairement, les doublons et les variantes filtrées n’ont pas à l’être. Son conseil : « Ne vous attendez pas à ce que toutes les URL de votre site soient indexées. […] Assurez-vous simplement que les pages clés de votre site sont indexées. »
Fais donc ta liste courte : accueil, pages de services ou de produits, pages qui t’amènent des clients. Vérifie celles-là une par une. Une fois indexées, il reste à mesurer ce qu’elles t’apportent : les visites se suivent avec l’outil présenté sur la page Google Analytics, c’est quoi, et la méthode pour analyser le trafic de ton site web est dans le même cocon.
L’indexation Google tient en trois idées. Indexée veut dire gardée par Google, pas bien placée. L’inspection d’URL de la Search Console est la seule vérification fiable pour une page. Et une page non indexée n’est un problème que si elle devait l’être. Commence aujourd’hui par inspecter ta page d’accueil.
Questions fréquentes
Peut-on forcer Google à indexer une page ?
Non. Tu peux demander l'indexation d'une page avec l'outil d'inspection d'URL de la Search Console, si tu es propriétaire ou utilisateur avec accès complet. Mais Google prévient qu'une demande d'exploration ne garantit pas une inclusion instantanée dans les résultats, et qu'il est même possible qu'elle n'ait pas lieu du tout. Un quota limite les envois, et répéter la demande pour la même adresse n'accélère rien (aide de Google lue le 30/10/2026).
Que veut dire « exploration » dans la Search Console ?
Explorer, c'est la visite de ta page par Googlebot, le robot de Google, qui télécharge son texte, ses images et ses vidéos. L'indexation vient après : Google analyse la page et la stocke dans son index. Une page peut donc être explorée sans être indexée : c'est le statut « Explorée, actuellement non indexée » (guide de la recherche Google et aide de la Search Console, lus le 30/10/2026).
Le budget de crawl concerne-t-il un petit site ?
En général, non. Google réserve son guide sur le budget d'exploration aux sites de plus d'un million de pages qui changent chaque semaine, aux sites de plus de 10 000 pages qui changent chaque jour, et aux sites dont beaucoup d'adresses sont « Détectée, actuellement non indexée ». Si tes pages sont explorées le jour de leur publication, Google dit que tu n'as pas besoin de ce guide : mets ton sitemap à jour et consulte le rapport sur l'indexation des pages (lu le 30/10/2026).
Une page indexée apparaît-elle forcément dans les résultats ?
Non. Google écrit que l'indexation d'une page ne garantit pas qu'elle figurera dans les résultats, qui sont personnalisés selon l'historique de recherche, la zone géographique et d'autres variables. Une page indexée peut aussi ne pas s'afficher si son contenu n'est pas pertinent pour les recherches ou s'il est de faible qualité (aides de Google lues le 30/10/2026).
Laisse ton IA faire les corvées de ta visibilité en ligne.
-10 % à vie sur ton abonnement avec mon lien, si tu t'abonnes dans les 2 semaines après ton inscription. Sans code. Tout sur le code promo SemChat
Lien affilié : ça ne te coûte rien de plus.
Sources vérifiées
- Google Search Central : guide détaillé de la recherche Google (30/10/2026)
- Aide de la Search Console : rapport sur l'indexation des pages (30/10/2026)
- Aide de la Search Console : outil d'inspection d'URL (30/10/2026)
- Google Search Central : demander à Google d'explorer de nouveau vos URL (30/10/2026)
- Google Search Central : opérateur de recherche site: (30/10/2026)
- Google Search Central : Googlebot (30/10/2026)
- Google Search Central : optimiser votre budget d'exploration (30/10/2026)
- Aide de la Search Console : que sont les impressions, les clics et la position ? (30/10/2026)
- Tarifs de SemChat (plan Free, plan Starter) (29/10/2026)